Je back-up taak is succesvol voltooid om 2:47 uur. Je controleert de logs, ziet het groene vinkje en gaat verder met je ochtend. Drie weken later versleutelt ransomware je productieomgeving en elke back-up kopie die aan hetzelfde netwerk is gekoppeld. De groene vinkjes betekenden niets. De back-ups waren er, maar ze waren niet veilig.
Dit scenario komt vaker voor dan de meeste IT-teams toegeven. De klassieke 3-2-1 back-up regel heeft organisaties meer dan een decennium goed gediend, maar ransomware-operators hebben datzelfde decennium besteed aan het leren hoe back-up systemen werken. Ze richten zich er doelbewust op. In 2026 is een back-up strategie die alleen op 3-2-1 is gebaseerd geen vangnet. Het is een vals gevoel van veiligheid.
Deze gids leidt je door de 3-2-1-1 back-up architectuur: wat het betekent, hoe je het implementeert op cloudinfrastructuur, en hoe je het kunt afstemmen op NIS2, DORA, GDPR en SOC 2 vereisten, zodat je volgende audit soepel verloopt.
Belangrijkste Inzichten
- De 3-2-1-1 back-up regel voegt één onveranderlijke, geïsoleerde kopie toe aan het klassieke 3-2-1 framework, de enige kopie die ransomware niet kan bereiken, zelfs niet na een volledige inbreuk op de inloggegevens.
- WORM (Write Once Read Many) opslag, afgedwongen op de opslaglaag, is de technische basis van onveranderlijkheid. Applicatielaag "alleen-lezen" vlaggen kwalificeren niet.
- RPO en RTO doelen moeten per workloadlaag worden gedocumenteerd, geautomatiseerd en regelmatig getest om te voldoen aan NIS2, DORA, GDPR Artikel 32 en SOC 2 Type II vereisten.
- Moderne ransomware-operators richten zich doelbewust op back-up agents, cloudopslag inloggegevens en snapshot schema's tijdens een verblijfsperiode die weken kan duren voordat de versleuteling begint.
- Hersteltests moeten auditor-klare records opleveren: tijdstempels, integriteitsverificatieresultaten, daadwerkelijke RTO en goedkeuring door een ingenieur, bewaard voor minimaal drie jaar.
Inhoudsopgave
- Waarom de Klassieke 3-2-1 Back-up Regel in 2026 Niet Meer Voldoende Is
- Wat de 3-2-1-1 Back-up Regel Eigenlijk Betekent (en Wat Elk Onderdeel Voor Je Doet)
- Ransomware Anatomie: Hoe Aanvallers Back-up Omgevingen Targeten
- Het Kiezen van de Juiste Opslaglaag voor Elke Back-up Kopie (NVMe, SSD, HDD)
- Hoe Geautomatiseerde Back-up te Configureren met Expliciete RPO en RTO Doelen
- Onveranderlijke Back-up Kopieën: Hoe Geïsoleerde en WORM Opslag Ransomware Versleuteling Stopt
- Hersteltesten en Auditevidentie: Van Geplande Oefeningen tot Auditor-Klare Rapporten
- Compliance Mapping: NIS2, DORA, GDPR en SOC 2 Vereisten die je Back-up Architectuur Moet Voldoen
- Stapsgewijze Implementatiechecklist voor een 3-2-1-1 Cloud Back-up Stack
- Ransomware Weerbaarheid Bouwen Is een Architectuurbeslissing, Geen Productbeslissing
Waarom de Klassieke 3-2-1 Back-up Regel in 2026 Niet Meer Voldoende Is
De oorspronkelijke 3-2-1 regel, gepopulariseerd door fotograaf Peter Krogh en later overgenomen door CERT en talloze IT-frameworks, is eenvoudig: houd 3 kopieën van je data, op 2 verschillende mediatypen, met 1 kopie offsite. Voor het grootste deel van de jaren 2000 en 2010 was dat solide advies.
Het probleem is dat ransomwaregroepen zijn geïndustrialiseerd. Moderne ransomwarefamilies jagen specifiek op back-up software agents, NAS-shares en cloud-verbonden opslagbuckets voordat ze versleuteling activeren. Ze spenderen dagen of weken in een netwerk voordat ze toeslaan, doelbewust wachtend tot back-up cycli schone herstelpunten overschrijven met versleutelde data. Tegen de tijd dat je de aanval opmerkt, is je "offsite" kopie óf ook versleuteld óf bevat het corrupte data die trouw is gerepliceerd over alle drie de kopieën.
Volgens back-up en herstelonderzoek dat de prioriteiten voor 2026 volgt, zijn onveranderlijkheid en geïsoleerde opslag verschoven van leuke extra's naar basisvereisten voor elke organisatie die serieus is over ransomwareherstel. De 3-2-1 regel hield nooit rekening met een aanvaller die je back-up inloggegevens al heeft gecompromitteerd.
Er is ook de regelgevende dimensie. NIS2, dat eind 2024 afdwingbaar werd in alle EU-lidstaten, en DORA, dat van toepassing is op financiële entiteiten vanaf januari 2025, vereisen beide aantoonbare herstelmogelijkheden met gedocumenteerde Recovery Time Objectives (RTO) en Recovery Point Objectives (RPO). Een back-up die bestaat maar niet kan worden bewezen te werken, voldoet niet aan een audit. De architectuur moet veranderen.
Wat de 3-2-1-1 Back-up Regel Eigenlijk Betekent (en Wat Elk Onderdeel Voor Je Doet)
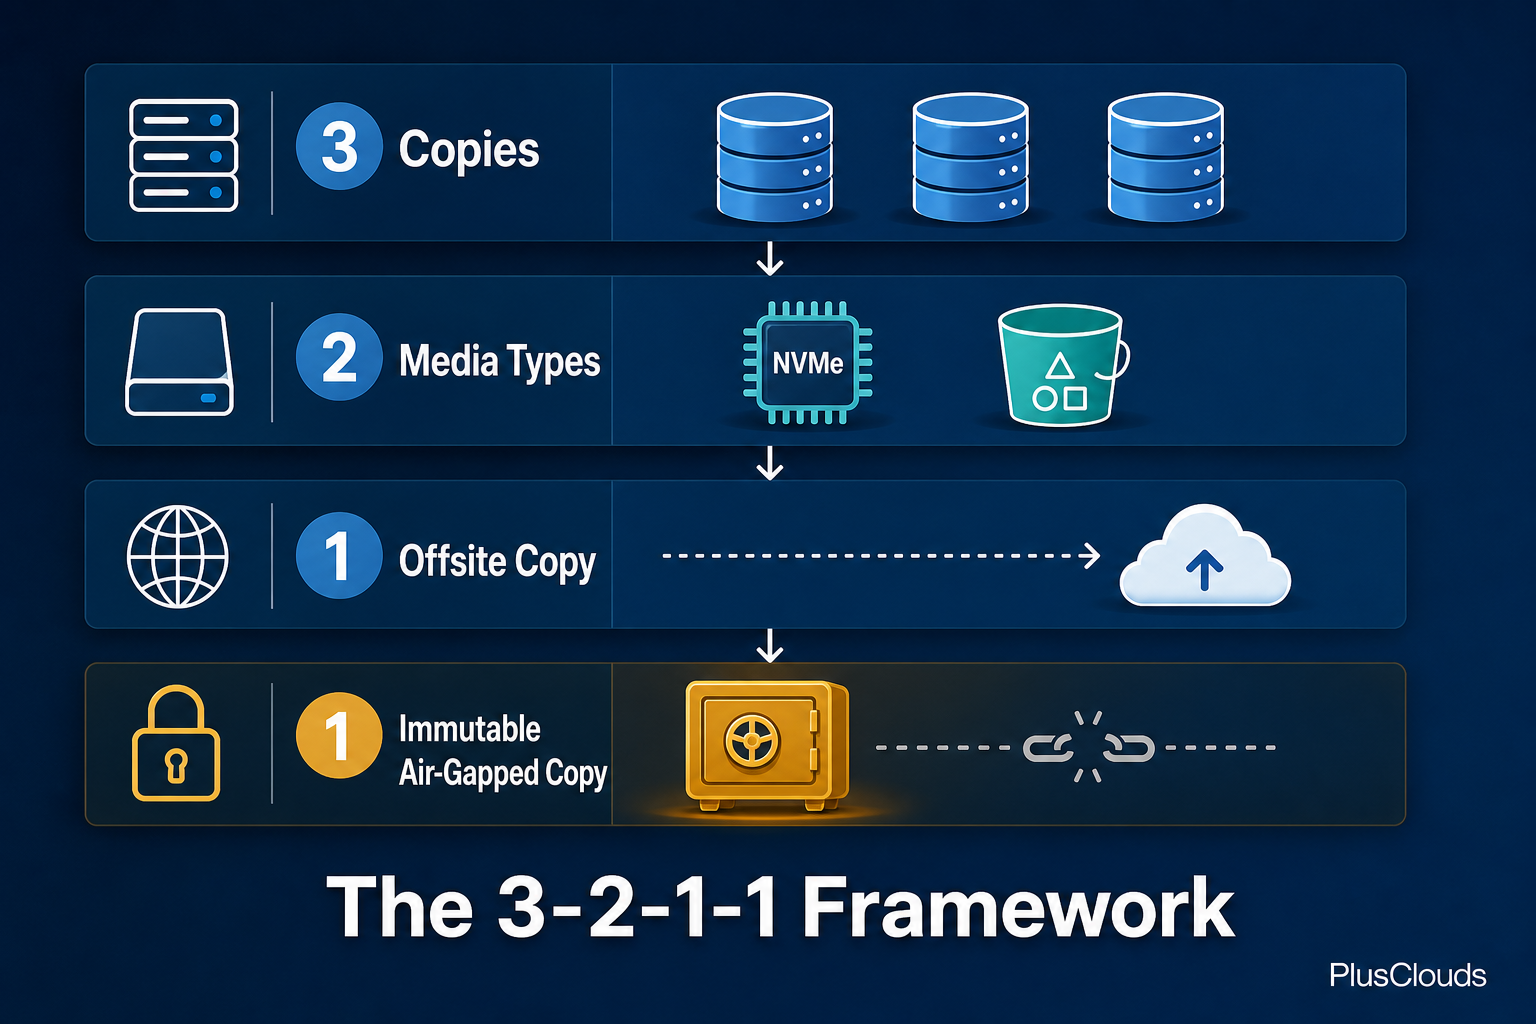
De 3-2-1-1 regel breidt het klassieke framework uit met één cruciale toevoeging. Hier is hoe elk onderdeel uiteenvalt:
- 3 kopieën van je data: je productiedata plus twee back-ups. Niet twee kopieën in totaal. Drie.
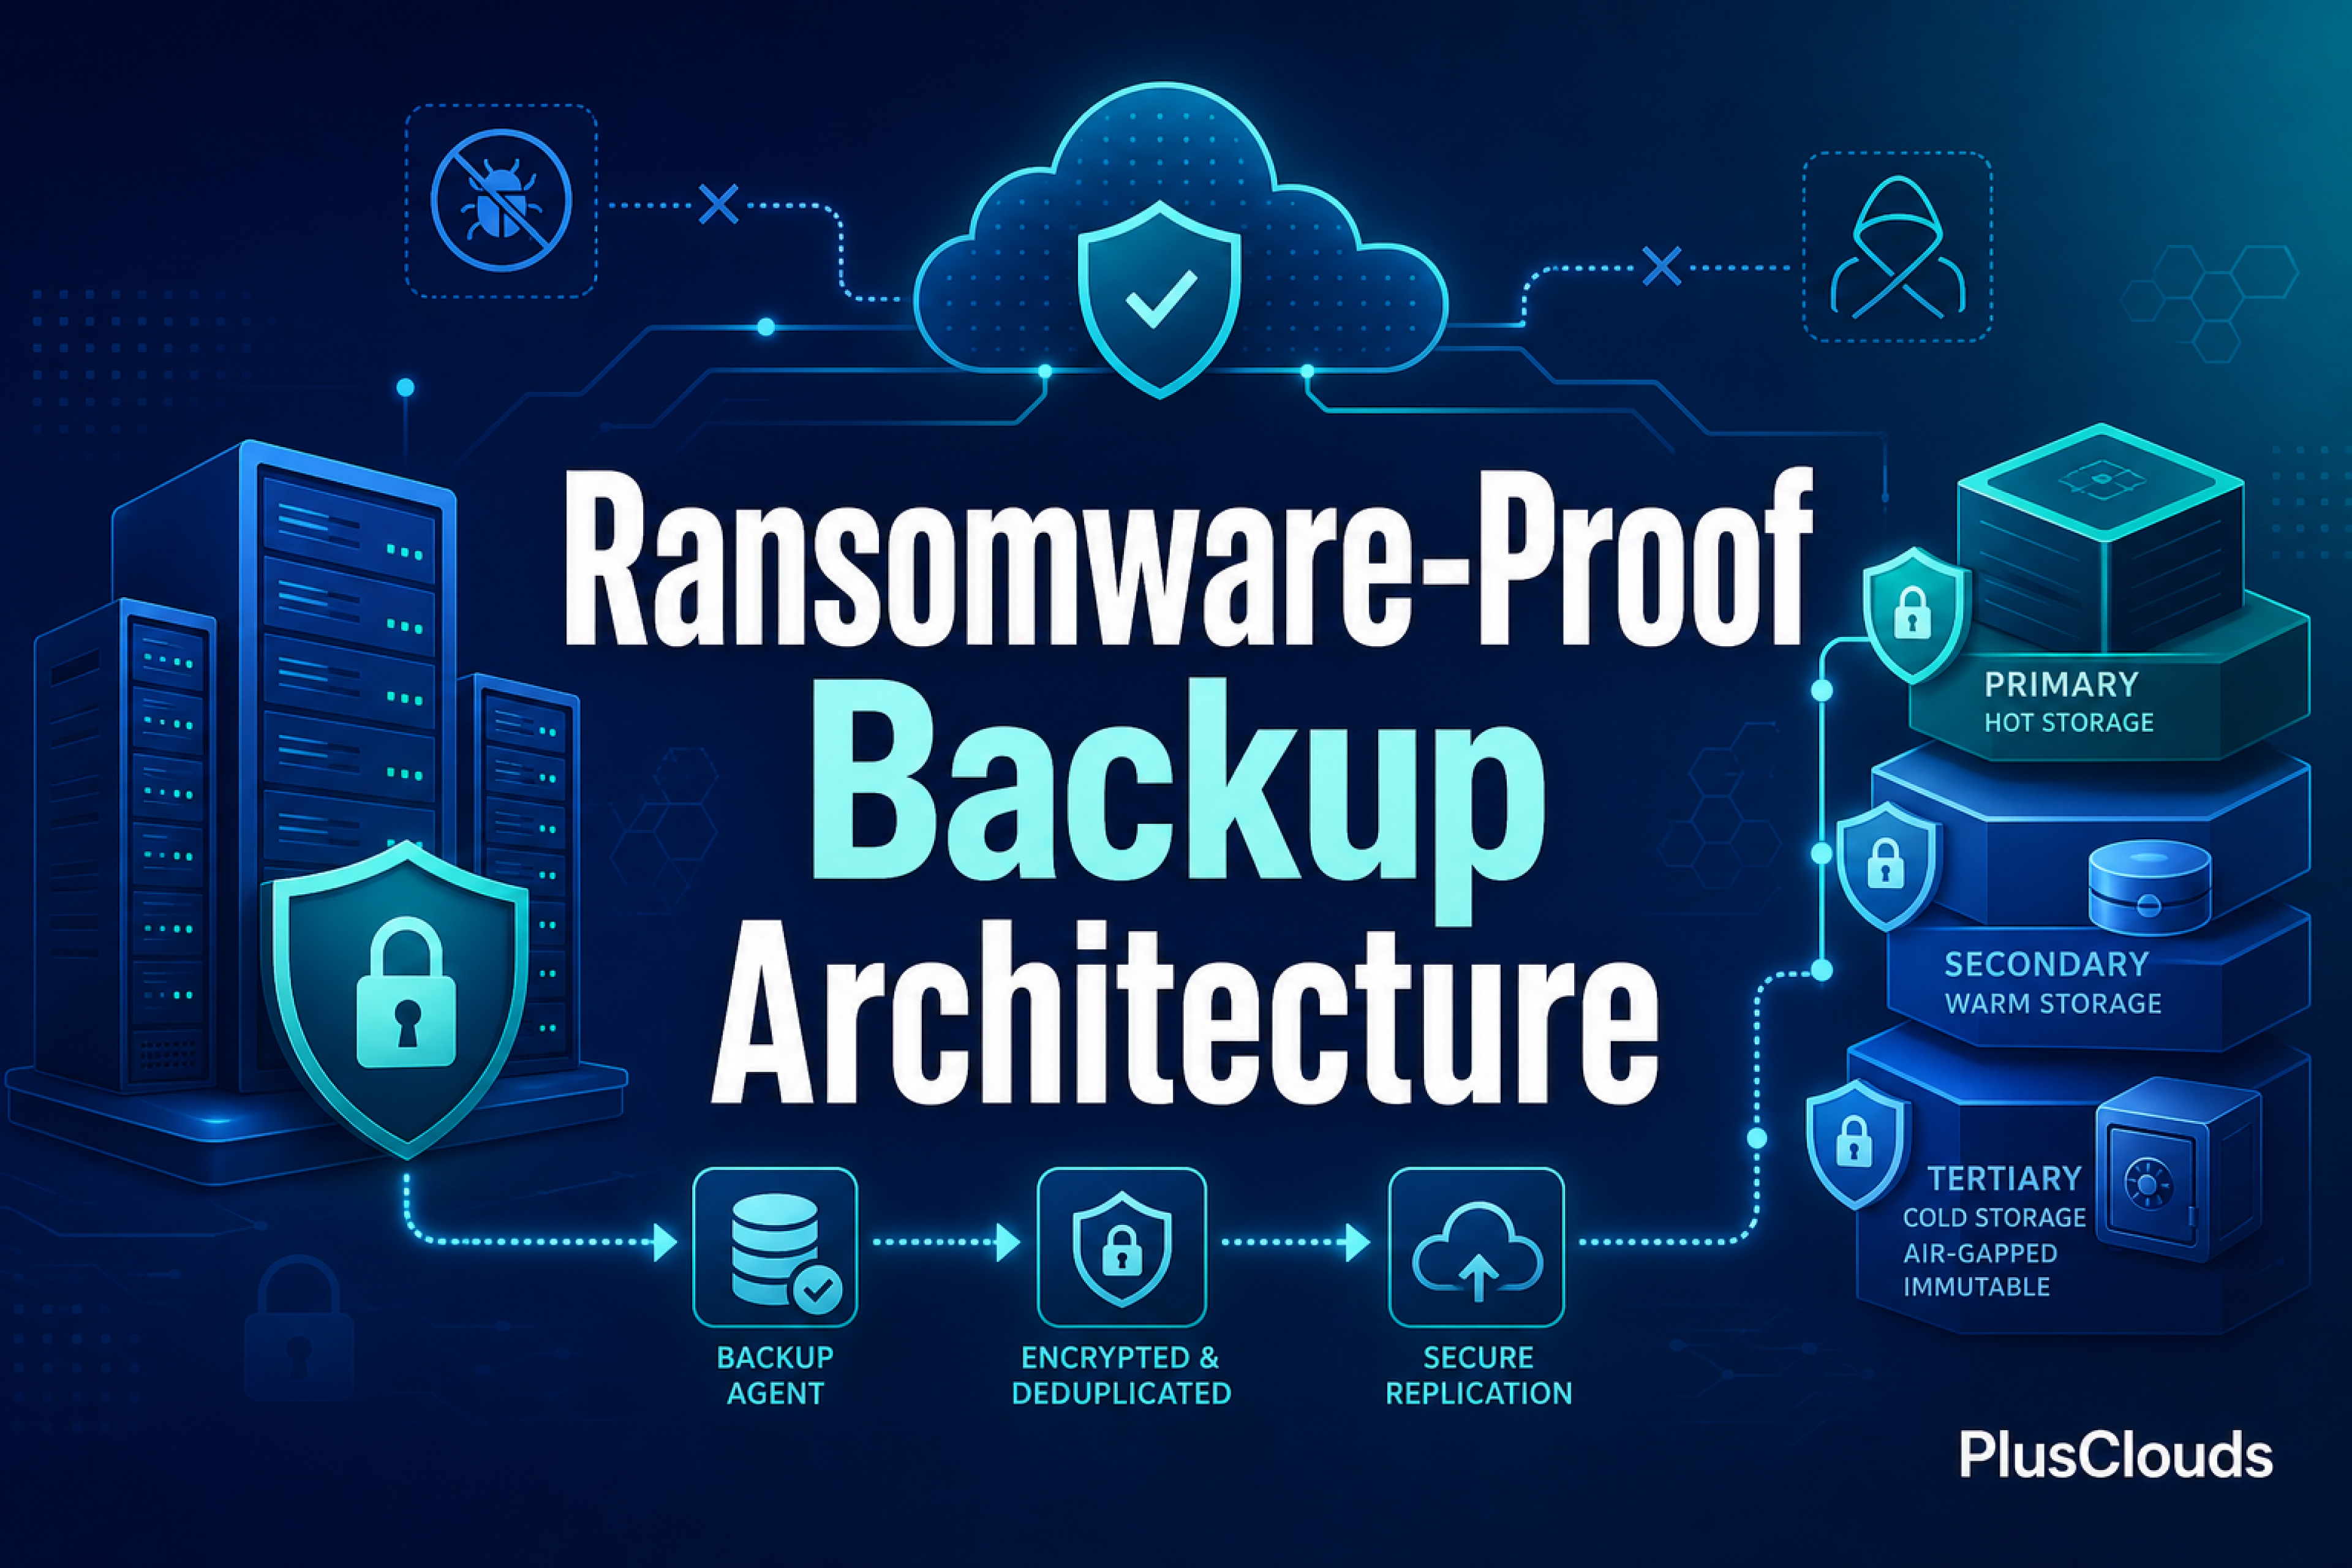
- 2 verschillende opslagmediatypen: bijvoorbeeld NVMe blokopslag voor je primaire back-up en objectopslag of tape voor de secundaire. Mediadiversiteit voorkomt dat een enkele leverancierfout of formatspecifieke bug alles uitwist.
- 1 offsite kopie: opgeslagen op een geografisch gescheiden locatie van je primaire infrastructuur. Een cloudregio in een ander land kwalificeert. Een tweede rack in hetzelfde datacenter niet.
- 1 onveranderlijke, geïsoleerde kopie: dit is de nieuwe toevoeging, en het is degene die daadwerkelijk ransomware stopt. Deze kopie kan niet worden gewijzigd, verwijderd of versleuteld door een proces, gebruiker of aanvaller die je omgeving heeft gecompromitteerd. Het bevindt zich buiten de explosieradius.
De laatste "1" is wat een moderne back-up architectuur scheidt van een die er op papier goed uitziet, maar faalt onder aanval. Onveranderlijkheid betekent write-once, read-many (WORM) opslag waar geen API-aanroep, geen beheerdersreferentie en geen ransomware payload de gegevens kan wijzigen of verwijderen zodra ze zijn geschreven. Air-gapping betekent dat de kopie geen permanente netwerkverbinding heeft met je primaire omgeving.
Samen garanderen deze twee eigenschappen dat zelfs als een aanvaller je cloudaccount volledig compromitteert, je productieservers, je back-up agents en je offsite replica, er nog steeds één kopie is die ze niet kunnen aanraken.
Ransomware Anatomie: Hoe Aanvallers Back-up Omgevingen Targeten
Het begrijpen van het aanvalsmodel is noodzakelijk voordat je een verdediging kunt ontwerpen. Ransomware-operators die zich richten op bedrijven, detoneren niet simpelweg op dag één. Een typische ransomware-inbraak in een onderneming volgt een voorspelbare volgorde.
Eerst, initiële toegang. Dit komt meestal via phishing, blootgestelde RDP of een kwetsbaarheid in een publiek toegankelijke applicatie. Eenmaal binnen beweegt de aanvaller zich lateraal en verhoogt stilletjes de privileges. Deze verblijftijd duurt gemiddeld weken tot maanden voordat de versleuteling begint.
Tijdens die verblijfsperiode zoeken aanvallers specifiek naar back-up infrastructuur. Ze identificeren back-up agents die op servers draaien, brengen verbonden opslagvolumes in kaart, lokaliseren cloudopslag inloggegevens in omgevingsvariabelen of configuratiebestanden, en inventariseren snapshot schema's. Hun doel is om back-ups direct te verwijderen, ze samen met productiedata te versleutelen, of ze op een manier te corrumperen die niet onmiddellijk duidelijk is.
Sommige ransomwarevarianten richten zich specifiek op back-up software API's. Anderen wachten simpelweg tot er genoeg back-up cycli zijn verstreken zodat alle herstelpunten versleutelde data bevatten. Een retentieperiode van 30 dagen klinkt genereus totdat je beseft dat de aanvaller al 45 dagen binnen is.
Dit is waarom de architectuur ertoe doet. Back-ups die netwerktoegankelijk zijn, zelfs als ze alleen-lezen zijn beperkt, zijn nog steeds potentieel bereikbaar als inloggegevens zijn gecompromitteerd. Alleen een kopie die fysiek of logisch is losgekoppeld van je omgeving, met onveranderlijke opslagkenmerken afgedwongen op de opslaglaag in plaats van de applicatielaag, overleeft dit aanvalsmodel betrouwbaar.
Het versterken van je back-up omgeving betekent ook het versterken van de servers die back-up taken uitvoeren. Als je workloads draait op Cloud Servers van PlusClouds, heb je volledige roottoegang en de mogelijkheid om back-up agents te isoleren op toegewijde instanties met strikt afgebakende netwerktoegang, waardoor het oppervlak voor laterale beweging aanzienlijk wordt verminderd.
Het Kiezen van de Juiste Opslaglaag voor Elke Back-up Kopie (NVMe, SSD, HDD)
Niet elke back-up kopie hoeft op de snelste beschikbare opslag te staan. Het afstemmen van de opslaglaag op de herstelprioriteit is zowel een kostenoptimalisatie als een architectuurbeslissing.
NVMe opslag is geschikt voor je meest recente back-up kopie, degene die je als eerste zult gebruiken in een herstelscenario. Snelle hersteltijden verminderen direct je RTO. Als je RTO-doel minder dan vier uur is, moet je primaire back-up op NVMe of high-performance SSD staan. Het herstellen van 2TB van een draaiende schijf met 150 MB/s duurt uren. Herstellen van NVMe met 3.000+ MB/s is een ander gesprek.
SSD opslag werkt goed voor je secundaire kopie, degene die offsite wordt gehouden of in een aparte cloudregio. Het balanceert kosten tegen redelijke herstelprestaties voor scenario's waarin de primaire back-up niet beschikbaar is.
HDD of objectopslag is de juiste laag voor je onveranderlijke archiefkopie. Deze kopie is je laatste redmiddel, niet je eerste oproep. Herstel ervan kan langer duren, maar dat is acceptabel omdat je er alleen naar grijpt wanneer alles anders heeft gefaald. De prioriteit hier is duurzaamheid en onveranderlijkheid, niet snelheid. Objectopslag met ingeschakelde WORM-beleid, of koude archieflagen aangeboden door grote cloudproviders, past goed in deze rol.
Cloud Storage van PlusClouds beslaat alle drie de lagen, NVMe, SSD en HDD, vanuit een enkel controlepaneel. Dat is praktisch van belang: je kunt je 3-2-1-1 architectuur configureren zonder drie afzonderlijke leveranciersrelaties of drie verschillende API's te beheren.
Hoe Geautomatiseerde Back-up te Configureren met Expliciete RPO en RTO Doelen
RPO (Recovery Point Objective) definieert hoeveel gegevensverlies je kunt tolereren, gemeten in tijd. Als je RPO vier uur is, heb je een back-up nodig die minstens elke vier uur wordt gemaakt. RTO (Recovery Time Objective) definieert hoe snel je weer online moet zijn na een storing. Dit zijn geen aspiratienummers. Ze zijn contractuele verplichtingen in de meeste compliance frameworks.
Het instellen van RPO en RTO doelen vereist eerlijke gesprekken over de impact op het bedrijf. Een database die financiële transacties verwerkt heeft een heel andere RPO dan een statische marketingwebsite. Begin met het classificeren van je workloads:
- Tier 1 (kritiek): RPO onder 1 uur, RTO onder 4 uur. Databases, authenticatiediensten, betalingssysteem.
- Tier 2 (belangrijk): RPO 4-8 uur, RTO onder 24 uur. Applicatieservers, interne tools, CRM-data.
- Tier 3 (standaard): RPO 24 uur, RTO 48-72 uur. Dev/test omgevingen, archieven, niet-productiesystemen.
Zodra je je tiers hebt, configureer je geautomatiseerde back-up schema's om overeen te komen. Een Tier 1 workload heeft minimaal elk uur snapshots nodig, met transactionele logback-ups die continu draaien als je database dit ondersteunt. Hier is een vereenvoudigd voorbeeld van hoe je dit zou kunnen plannen met een cron-gebaseerde back-up agent:
# Tier 1: elk uur snapshot, bewaard voor 72 uur
0 * * * * /usr/local/bin/backup-agent snapshot --target prod-db-01 --retention 72h

# Dagelijkse volledige back-up om 01:00, bewaard voor 30 dagen
0 1 * * * /usr/local/bin/backup-agent full --target prod-db-01 --retention 30d

# Wekelijkse back-up naar onveranderlijke opslag, bewaard voor 1 jaar
0 2 * * 0 /usr/local/bin/backup-agent archive --target prod-db-01 --storage immutable --retention 365d
De sleutel hier is dat RPO en RTO doelen moeten worden gedocumenteerd, getest en gevolgd. Automatisering regelt de planning, maar je hebt SLA dashboards nodig die laten zien of back-ups op tijd zijn voltooid en of hersteltests hun RTO hebben gehaald. Automated Backup van PlusClouds omvat expliciete RPO/RTO doelconfiguratie en SLA tracking, zodat je het auditspoor ingebouwd hebt in plaats van achteraf toegevoegd.
Onveranderlijke Back-up Kopieën: Hoe Geïsoleerde en WORM Opslag Ransomware Versleuteling Stopt
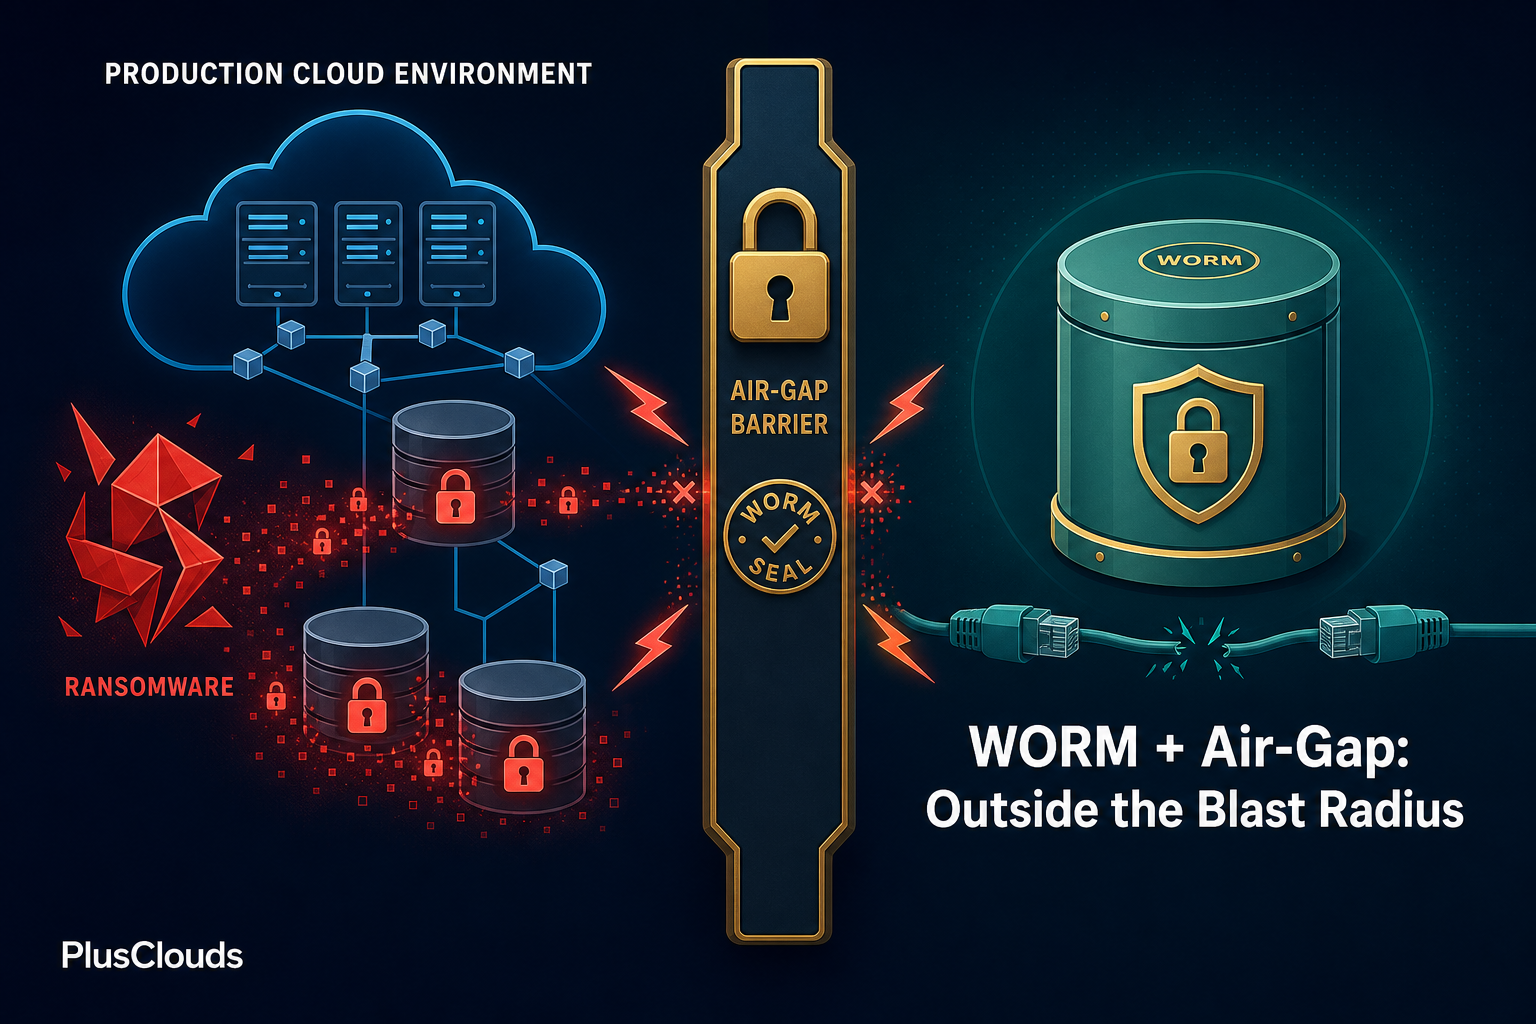
Onveranderlijkheid wordt afgedwongen op de opslaglaag, niet de applicatielaag. Dit onderscheid is cruciaal. Een applicatielaag "alleen-lezen" vlag kan worden gewijzigd door iedereen met voldoende rechten, inclusief een aanvaller die beheerdersreferenties heeft gestolen. Opslaglaag onveranderlijkheid, geïmplementeerd via WORM (Write Once Read Many) beleid, kan niet worden overschreven door enige API-aanroep of referentie, inclusief root.
WORM opslag werkt door objecten te vergrendelen voor een gedefinieerde retentieperiode op het moment van schrijven. Tijdens die periode kan geen enkel proces het object wijzigen of verwijderen. De vergrendeling wordt afgedwongen door het opslagsysteem zelf, niet door toegangscontrolebeleid dat kan worden gewijzigd.
Air-gapping gaat nog verder door het netwerkpad volledig te verwijderen. Een echte air-gap betekent geen permanente verbinding tussen je productieomgeving en de back-up kopie. In cloudomgevingen wordt dit meestal geïmplementeerd door:
- Object lock met governance of compliance modus: AWS S3 Object Lock, Azure Immutable Blob Storage en gelijkwaardige diensten dwingen WORM af op het opslag API-niveau.
- Periodieke offline export: snapshots geëxporteerd naar koude opslag zonder actieve aankoppelpunt.
- Gescheiden cloudaccount zonder cross-account schrijfrechten: het back-up account kan gegevens ontvangen via een eenrichtingspush, maar productie referenties kunnen geen objecten verwijderen of wijzigen in het back-up account.
De combinatie van WORM beleid en accountisolatie is het praktische cloud equivalent van een air-gap. Een aanvaller die je productie cloudaccount volledig heeft gecompromitteerd, kan nog steeds geen objecten bereiken in een gescheiden account waar ze geen referenties hebben en waar de objecten zijn vergrendeld op de opslaglaag.
Voor omgevingen die gevoelige gegevens verwerken onder GDPR, merk op dat onveranderlijke opslag zorgvuldige planning vereist rond het recht op verwijdering. Je hebt een gedocumenteerd proces nodig voor het afhandelen van verwijderingsverzoeken tegen onveranderlijke kopieën, meestal door pseudonimisering bij binnenkomst in plaats van verwijdering achteraf.
Hersteltesten en Auditevidentie: Van Geplande Oefeningen tot Auditor-Klare Rapporten
Een back-up die nooit is getest, is geen back-up. Het is een hypothese. De enige manier om te weten dat je herstelarchitectuur werkt, is door het te gebruiken, opzettelijk, voordat je het onder druk nodig hebt.
Hersteltesten hebben twee vormen: hersteltests en volledige hersteloefeningen. Hersteltests verifiëren dat individuele bestanden, databases of VM-snapshots succesvol kunnen worden hersteld naar een bekende goede staat. Ze moeten minstens maandelijks worden uitgevoerd voor Tier 1 workloads. Volledige hersteloefeningen simuleren een volledige omgevingsstoring en meten de daadwerkelijke RTO tegen je doel. Deze moeten elk kwartaal worden uitgevoerd.
Voor auditor-klare bewijzen heeft elke test een gedocumenteerd record nodig dat omvat:
- Datum en tijd van de test
- Geteste workload en gebruikte back-up kopie
- Herstel starttijd en voltooiingstijd (daadwerkelijke RTO)
- Methode voor gegevensintegriteitsverificatie (checksum vergelijking, applicatieniveau rooktest)
- Pass/fail resultaat en eventuele genomen herstelmaatregelen
- Handtekening of goedkeuring van de verantwoordelijke ingenieur
Geautomatiseerde hersteltesten, waarbij een geplande taak een herstelomgeving opzet, integriteitscontroles uitvoert en het resultaat logt zonder menselijke tussenkomst, is de gouden standaard. Het verwijdert het probleem "we wilden testen maar het werd steeds gedeprioriteerd" dat herstelstoringen veroorzaakt bij echte incidenten.
Bewaar deze records minimaal drie jaar. NIS2 en DORA vereisen beide dat organisaties aantoonbare herstelcapaciteit kunnen laten zien, niet alleen een eenmalige architectuurbeoordeling.
Compliance Mapping: NIS2, DORA, GDPR en SOC 2 Vereisten die je Back-up Architectuur Moet Voldoen
Compliance frameworks schrijven geen specifieke back-up technologieën voor, maar ze vereisen wel resultaten die je architectuur moet leveren. Hier is hoe het 3-2-1-1 model aansluit op de belangrijkste frameworks:
NIS2 (EU Netwerk- en Informatiebeveiligingsrichtlijn 2): Vereist dat essentiële en belangrijke entiteiten back-upbeheer, bedrijfscontinuïteitsmaatregelen en incidentresponsmogelijkheden implementeren. Artikel 21 roept specifiek op tot gedocumenteerde herstelprocedures met geteste RTO/RPO doelen. Je onveranderlijke kopie en geautomatiseerde hersteltesten voldoen direct aan deze eis.
DORA (Digital Operational Resilience Act): Van toepassing op financiële diensten entiteiten in de EU. Vereist ICT bedrijfscontinuïteitsbeleid met gedefinieerde hersteldoelen, regelmatige testen van back-up en herstelprocedures, en documentatie van testresultaten. DORA vereist ook dat externe ICT-providers (inclusief cloudproviders) voldoen aan veerkrachtstandaarden, dus de eigen compliance houding van je cloud back-up leverancier is van belang.
GDPR (Algemene Verordening Gegevensbescherming): Vereist passende technische maatregelen om gegevensbeschikbaarheid en veerkracht te waarborgen. Artikel 32 verplicht de mogelijkheid om de beschikbaarheid van persoonsgegevens tijdig te herstellen na een incident. Je Tier 1 RTO doelen en onveranderlijke kopieën adresseren dit direct. De complicatie, zoals hierboven opgemerkt, is het verzoenen van onveranderlijkheid met verwijderingsrechten onder Artikel 17.
SOC 2 Type II: Het Availability trust service criterium vereist gedocumenteerde back-upprocedures, testbewijzen en monitoring. Type II certificering vereist bewijs van operationele effectiviteit over een periode van tijd, meestal zes tot twaalf maanden, dus je geautomatiseerde testlogs en SLA dashboards zijn geen optionele extra's. Ze zijn de audit artefacten.
De Cloud Security aanbieding van PlusClouds omvat ISO 27001, SOC 2 en GDPR compliance documentatie, wat het leveranciersbeoordelingsgedeelte van je audit vereenvoudigt. Je auditor moet niet alleen je back-up architectuur verifiëren, maar ook de compliance houding van de infrastructuur waarop het draait.
Stapsgewijze Implementatiechecklist voor een 3-2-1-1 Cloud Back-up Stack
Gebruik deze checklist om je back-up architectuur te bouwen of te auditeren. Elk item komt overeen met een sectie die in deze gids wordt behandeld.
Classificeer en documenteer workloads:
- Wijs elke productie workload toe aan Tier 1, 2 of 3
- Definieer RPO en RTO doelen per tier schriftelijk
- Verkrijg goedkeuring van zakelijke belanghebbenden voor die doelen
Configureer je drie kopieën:
- Primaire back-up op NVMe of high-performance SSD, samen met productie voor snelle herstel
- Secundaire back-up op SSD in een aparte cloudregio of beschikbaarheidszone
- Onveranderlijke archiefkopie op WORM-ingeschakelde objectopslag in een apart cloudaccount
Handhaaf onveranderlijkheid:
- Schakel object lock (compliance modus, niet governance modus) in op je archiefopslag
- Verifieer dat geen productie referenties verwijder- of wijzigingsrechten hebben op het archiefaccount
- Stel minimale retentieperioden in die zijn afgestemd op je compliance vereisten (meestal 1-7 jaar)
Automatiseer back-up taken:
- Plan back-ups op frequenties die overeenkomen met je RPO doelen per tier
- Configureer waarschuwingen voor gemiste of mislukte back-up taken
- Schakel SLA tracking in om de daadwerkelijke voltooiing van back-ups te meten tegen het schema
Versterk de back-up omgeving:
- Voer back-up agents uit op geïsoleerde instanties zonder onnodige inkomende netwerktoegang
- Draai back-up referenties op een schema en bewaar ze in een geheimenbeheerder
- Schakel multi-factor authenticatie in op alle accounts met toegang tot back-up infrastructuur
Test en documenteer herstel:
- Voer maandelijkse hersteltests uit voor Tier 1 workloads
- Voer driemaandelijkse volledige hersteloefeningen uit met gemeten RTO
- Bewaar testrecords met tijdstempels, resultaten en goedkeuring door een ingenieur voor minimaal drie jaar
Map naar compliance vereisten:
- Documenteer je back-up architectuur in je informatiebeveiligingsbeleid
- Map elk back-up onderdeel naar de relevante NIS2, DORA, GDPR of SOC 2 controle
- Neem back-up testbewijzen op in je jaarlijkse auditpakket
De architectuur beschreven in deze checklist is niet theoretisch. Het is het patroon dat organisaties die succesvol herstellen van ransomware-aanvallen in 2025 en 2026 gemeen hebben, zoals onderzoek naar veerkracht van enterprise back-up consistent bevestigt.
Ransomware Weerbaarheid Bouwen Is een Architectuurbeslissing, Geen Productbeslissing
De 3-2-1-1 regel is een framework, geen product. Geen enkel hulpmiddel maakt je back-ups automatisch ransomware-proof. Wat ze veerkrachtig maakt, zijn bewuste architectuurbeslissingen: gelaagde opslag afgestemd op herstelprioriteit, onveranderlijkheid afgedwongen op de opslaglaag, automatisering die menselijke fouten uit het back-up schema verwijdert, en regelmatige testen die bewijzen dat het systeem werkt voordat je het nodig hebt.
De compliance hoek versterkt de architectuur. NIS2 en DORA geven organisaties niet de optie om back-up testen als een laagprioriteitstaak te behandelen. Gedocumenteerde, geteste en controleerbare herstelmogelijkheden zijn nu een wettelijke vereiste voor een aanzienlijk deel van de Europese bedrijven, en die vereiste wordt gehandhaafd.
Als je klaar bent om van een 3-2-1 houding over te stappen naar een echt ransomware-resistente 3-2-1-1 architectuur, biedt Automated Backup van PlusClouds je de RPO/RTO configuratie, SLA tracking en remote restore mogelijkheden om daar te komen zonder de tooling vanaf nul te bouwen. Combineer het met Cloud Storage van PlusClouds voor gelaagde NVMe, SSD en HDD opslag over een enkel controlepaneel, en je hebt de infrastructuurlaag van je 3-2-1-1 stack gedekt. De architectuurbeslissingen zijn aan jou. De infrastructuur om ze te ondersteunen is klaar wanneer jij dat bent.